Una vez construida la API de extracción en Python, el siguiente paso es conectar las piezas del ecosistema. Para orquestar todo el flujo de trabajo sin sobrecomplicar la infraestructura, utilicé Make como centro de mando.
El objetivo de este escenario es actuar como el nexo de unión que coordina los eventos: desde la revisión periódica del correo hasta que la información queda guardada y respaldada de forma segura.
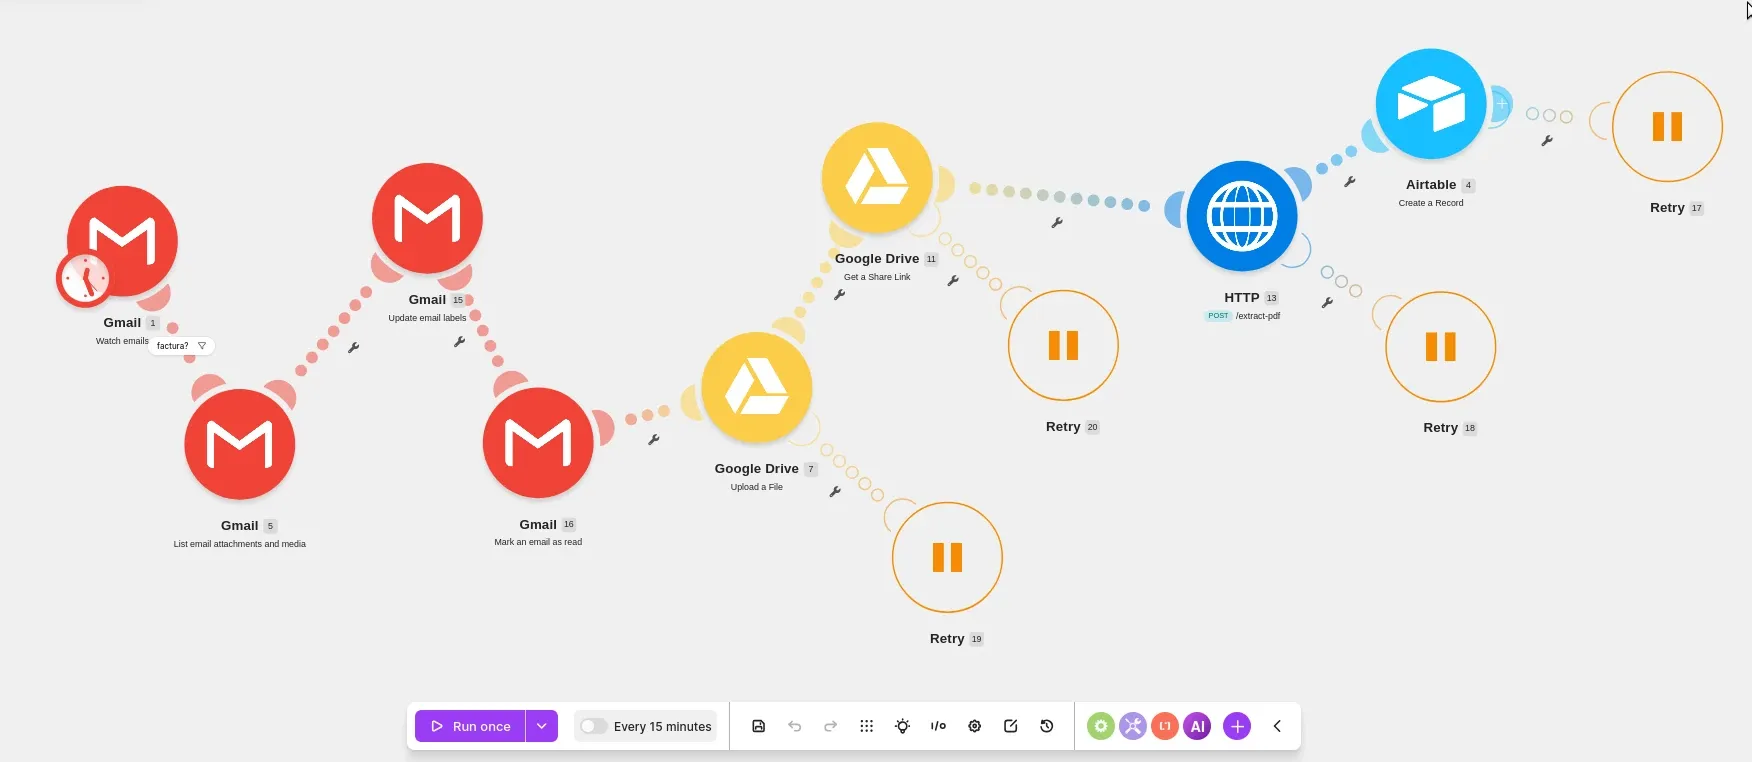
El paso a paso del escenario en Make
- Verificación programada de correos (Gmail): Para optimizar el consumo de créditos en Make y tener un control preciso del coste, el escenario se ejecuta en intervalos programados. Busca correos sin leer que contengan archivos adjuntos PDF y cumplan con los filtros establecidos (como etiquetas o palabras clave específicas).
- Respaldo automatizado en Google Drive: Antes del procesamiento, el archivo PDF se sube directamente a una carpeta específica en Google Drive. Esto genera un histórico unificado y una copia de seguridad permanente accesible para el equipo de contabilidad o la gestoría.
- Petición HTTP a la API (FastAPI): Make envía el archivo PDF mediante una petición HTTP POST al microservicio en Python. La API procesa el archivo en memoria y responde en milisegundos con los datos estructurados (proveedor, número de factura, fecha normalizada e importe).
- Registro estructurado en Airtable: Con los datos limpios devueltos por la API, Make crea un nuevo registro en la base de datos de Airtable, incluyendo el enlace directo al archivo almacenado en Google Drive para garantizar la trazabilidad.
- Organización de la bandeja de entrada: Finalmente, el escenario marca el correo como leído y le aplica la etiqueta
factura-procesada-automáticamente. Esto evita reprocesar correos y mantiene la bandeja limpia sin intervención manual.
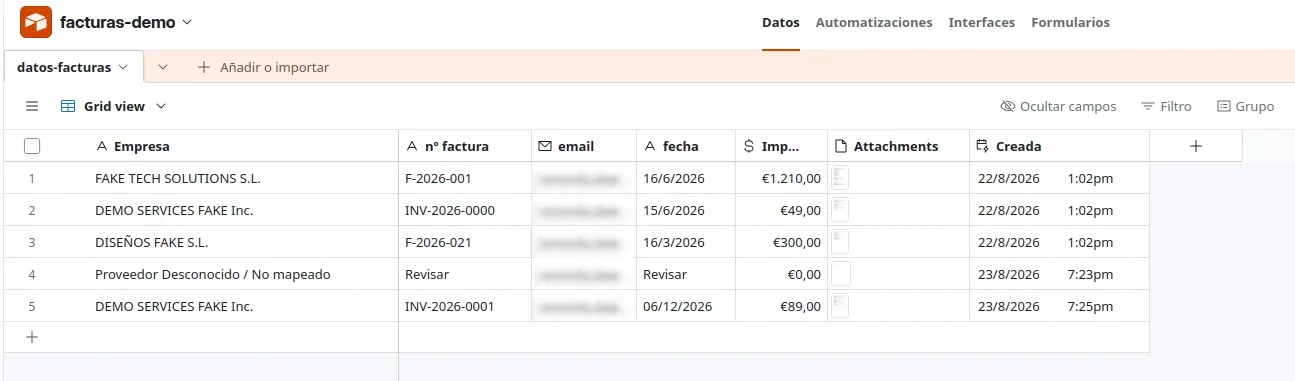
El resultado final en Airtable
A diferencia de una hoja de cálculo tradicional (como Excel o Google Sheets), Airtable actúa como una base de datos relacional con soporte nativo para adjuntos. Esto permite transformar una simple tabla de registro en un gestor documental completo:
- Campos clave estructurados: Proveedor, Nº de Factura, Fecha (
DD/MM/YYYY) e Importe Total identificados y procesados en celdas independientes, listos para filtrar o exportar. - Acceso directo al PDF (
Attachments): Cada fila incluye el propio archivo PDF de la factura adjunto. El usuario puede hacer clic en la celda para abrir una vista previa interactiva a pantalla completa de la factura sin necesidad de ir a buscar el archivo a Google Drive o a la bandeja de correo. - Control de revisión: Si entra una factura de un proveedor nuevo no configurado, el sistema asigna el estado “Revisar”, permitiendo completar la información manualmente en un clic.
Análisis de impacto estimado: El valor de automatizar este proceso
Para entender el retorno de este tipo de soluciones, conviene analizar un ejemplo estimado en un volumen modesto de unas 50 facturas mensuales:
- El coste en tiempo: Un perfil administrativo o un profesional independiente dedica de media unos 4 minutos por factura (abrir correo, descargar, renombrar, clasificar en Drive y picar los datos en Excel o Airtable). Esto equivale a unas 3,5 horas mensuales de trabajo repetitivo (más de 40 horas al año).
- El valor del tiempo:
- En una empresa con equipo, si calculamos un coste medio para el empresario de 18 € - 25 €/hora por empleado administrativo, la gestión manual supone un gasto indirecto de entre 700 € y 1.000 € al año en picar datos.
- En un negocio unipersonal o freelance, el impacto es aún mayor: 40 horas al año no facturables que se restan de captar clientes, ejecutar proyectos o descansar.
- El coste de infraestructura: Al no consumir APIs de IA comerciales con tarifas de pago por página procesada, el gasto recurrente es mínimo. Para este proyecto, el motor en Python (FastAPI) se alojó como microservicio serverless en Vercel, pero es un sistema totalmente portable a plataformas gestionadas similares según las preferencias del cliente. En cualquier caso, se trata de costes de hosting totalmente previsibles e insignificantes en comparación con el ahorro generado.
Próxima evolución: Fallback inteligente con LLM Local (Ollama)
Este sistema requiere mapear previamente la plantilla de cada nuevo proveedor para extraer sus datos con precisión matemática.
Para resolver esta limitación manteniendo la privacidad y la independencia de APIs de pago por uso, la Fase 2 integrará un modelo de lenguaje local procesado con Ollama. Cuando el motor detecte un “Proveedor Desconocido”, recurrirá al LLM local para interpretar el PDF sobre la marcha sin enviar datos financieros a terceros.